誰在用、缺什麼:光源短缺、配比、OCS 與各家採用節奏
技術路線清楚了,接下來是現實面:雷射夠不夠、每顆 GPU 要配幾顆光模組、Google 為什麼用全光交換器、七家雲端業者各走到哪一步。
整理自 Goldman Sachs Global Investment Research《Global Tech: Optical Networking — The next mega trend in AI infrastructure》(2026-04-17,公開流通的節錄版)。文中所有 Exhibit 圖表皆截自該報告,編號依高盛原報告,不依本篇閱讀順序;數字為高盛估計(GSe),非公司財測。數字與採用表以 2026 年 4 月報告當時為準,不反映之後的訂單與產能更新。
命名對照:本文的 VR200 就是 Vera Rubin 世代的 NVL72 機櫃(2026E);Rubin Ultra 是再下一代(2027E)。
一句話
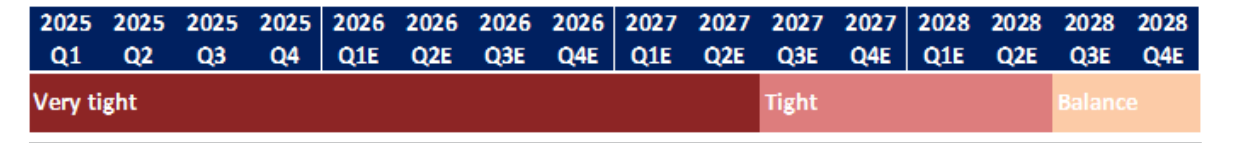
- 雷射缺到 2027 年。EML 和連續波雷射都吃磷化銦基板,AI 需求、速率升級、擴產時間差三件事疊在一起,高盛預期 2028 下半年才回到平衡。
- 配比翻倍。NVIDIA VR200 每顆 GPU 配 4 到 6 顆 1.6T 光模組,GB300 是 2 到 3 顆;原因是 GPU 對外速率翻倍,交換器速率沒變。
- OCS 是「不用換交換器就能升速」的方案。光路交換器不做光電轉換,800G、1.6T、3.2T 的光走同一條路。Lumentum ($LITE) 的 OCS 積壓訂單 2026 年 2 月已超過 4 億美元。
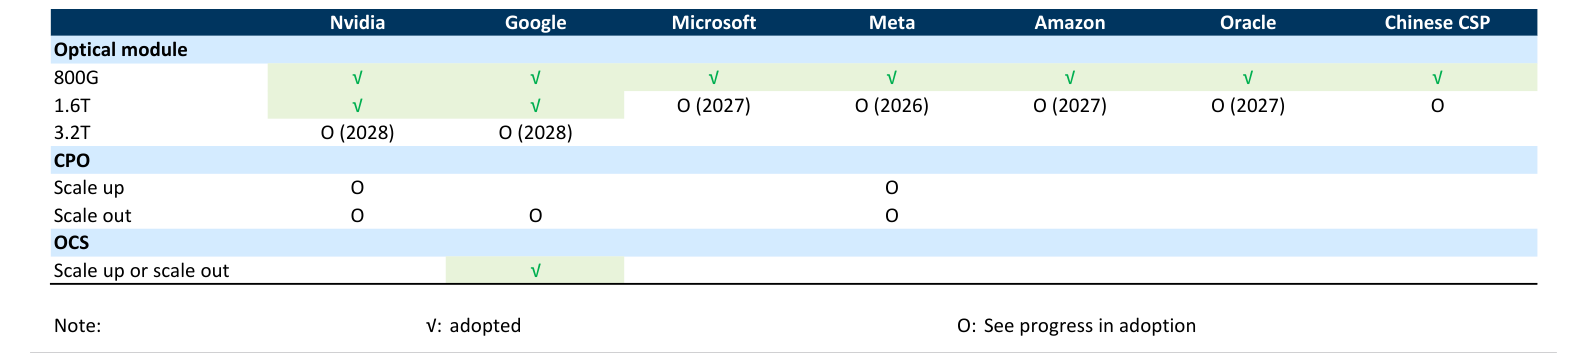
- 採用節奏各家不同。800G 七家全數採用;1.6T 只有 NVIDIA 和 Google 已採用;CPO 只有 NVIDIA、Google、Meta 在推進;OCS 只有 Google 已採用。
光源:供應鏈與短缺
光模組和 CPO 都要雷射,雷射要磷化銦基板。2026 年供應仍然緊。
高盛列了三個原因。第一,需求太強:AI 伺服器放量、速率升級、光連線的範圍擴大,三者同時發生。第二,磷化銦(InP,Indium Phosphide)基板供應受限。EML 和連續波雷射都用它,發射端的雷射二極體(LD)和接收端的光偵測器(PD)也都用它,而且它還在中國政府的地緣政治與出口管制範圍裡。第三,擴產和爬坡需要時間。
供應鏈正在擴產。全新 (2455) 計畫在 2026 下半年把磷化銦 MOCVD 從 60 台擴到 64 台;聯亞 (3081) 和源杰科技 (中國・688498) 都承諾 2026 年大幅擴產;Lumentum ($LITE) 計畫從 2025 年第三季到 2026 年第二季擴產 40%,2026 年可能再開更多產能;Coherent ($COHR) 承諾產能翻倍。
高盛的整體判斷:光源供應緊到 2027 年,2028 下半年可能轉為平衡。三個可能提早鬆的變數:供應鏈擴產到位、AI 伺服器規格升級放慢(產業從訓練轉向推論)、中國的地緣政治與出口管制放鬆。
CPO 的光源有三種選擇
CPO 的光源不只一種。連續波雷射是光模組裡最普及的光源,能走長距離,scale-out 和 scale-up 都能用。垂直共振腔面射型雷射(VCSEL)技術成熟、能耗更低,距離比連續波雷射短,但 scale-up 夠用。微發光二極體(MicroLED)是 scale-up 的另一個選項,能耗低、延遲低,但技術成熟度還不如前兩者。
| 矽光子 + 連續波雷射 | VCSEL | MicroLED | |
|---|---|---|---|
| 能源效率 | 較低 | 高 | 高 |
| 有效距離 | 1 公里以上 | 100 公尺以內 | 20 公尺以內 |
| 延遲 | 低到中 | 低到中 | 低 |
| 每位元成本 | 中 | 低 | 低 |
| 技術成熟度 | 高 | 高 | 低 |
資料來源:Exhibit 36,Company data、Goldman Sachs Global Investment Research
配比:每顆 GPU 配幾顆光模組
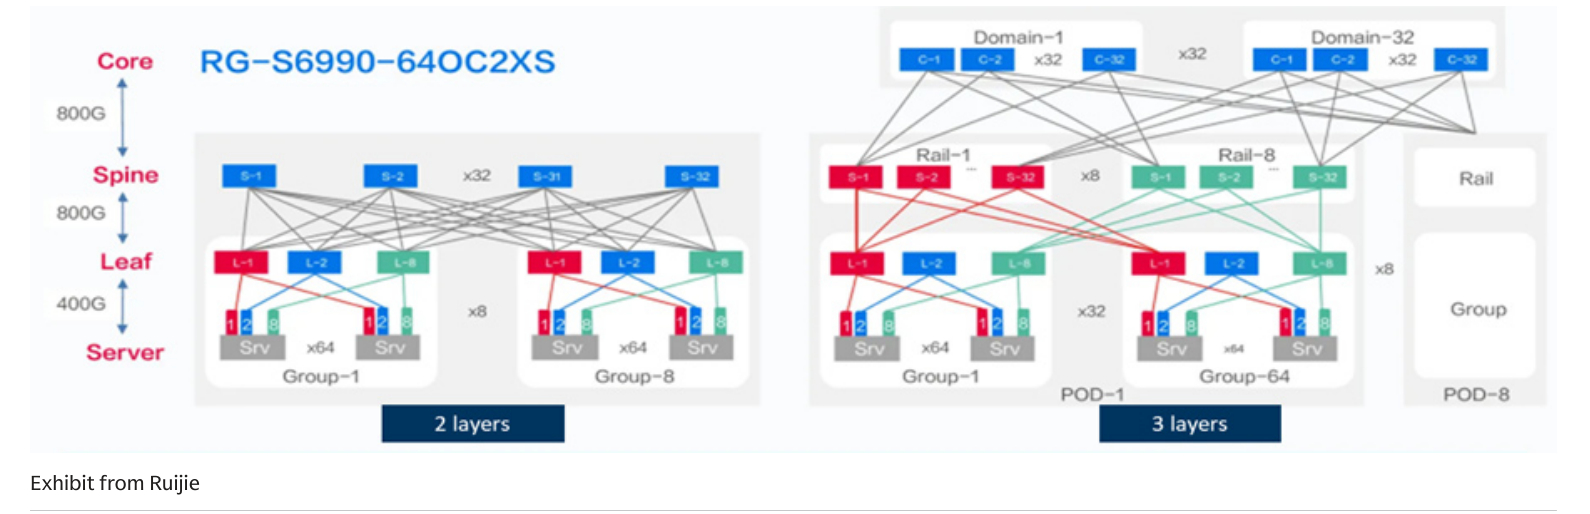
配比(attach rate)是「一顆 GPU 對幾顆光模組」。它由兩件事決定:網路有幾層、連線裡用了多少光。
先對齊口徑:第一篇的 NVIDIA 機櫃模型取的是上限(GB300 1:3、Vera Rubin 1:6),下表是高盛對各家平台給的區間。表中的 VR200 就是第一篇的 Vera Rubin NVL72。
| 廠商 | 機種 | 年份 | 配比(GSe) | 速率 |
|---|---|---|---|---|
| NVIDIA $NVDA | GB200 | 2024 | 1:2 到 1:3 | 800G |
| GB300 | 2025 | 1:2 到 1:3 | 1.6T | |
| VR200 | 2026 | 1:4 到 1:6 | 1.6T | |
| Rubin Ultra | 2027 | 未定 | 3.2T(GSe) | |
| Google $GOOGL | TPU v6 | 2024 | 1:4 | 800G |
| TPU v7 | 2025 | 1:4 | 1.6T | |
| Amazon $AMZN | Trainium 2 | 2025 | 1:4 | 400G |
| Trainium 3(Teton 3 PDS/MAX) | 2026 | 1:4 | 未定 | |
| Meta $META | MTIA-T V1(Minerva) | 2026 | 1:8 到 1:12 | 800G(GSe) |
| Huawei(未上市) | CloudMatrix 384 | 2025 | 1:18 | 400G |
| 壁仞科技 (香港・6082) | BR20x | 2026 | 未定 | 400G/800G |
速率指網路裡最快的一段。資料來源:Exhibit 38,Company data、Goldman Sachs Global Investment Research
一萬顆 GPU 的大叢集需要三層網路,小叢集兩層就夠,層數越多、光模組越多。NVIDIA 的 VR200 配比從 GB300 的 1 比 2 到 3 拉到 1 比 4 到 6,翻了一倍,原因很單純:運算托盤那一側每顆 GPU 的埠速率從 800G 升到 1.6T,網路那一側的交換器速率還是 1.6T,同樣的頻寬要用更多顆光模組去接。
Google 和 Amazon 的 ASIC 配比都在 1 比 4,因為它們在 scale-up 和 scale-out 用了銅纜和 OCS。Meta 的 ASIC 配比更高,1 比 8 到 12(800G),原因是它的分散式排程網路架構(DSF,Disaggregated Scheduled Fabric)比較複雜。華為的 CloudMatrix 384 全部用光連線,配比 1 比 18。其他中國 GPU 與 ASIC 通常是一台伺服器 8 顆 GPU 的標準設計,配比 1 比 4 到 6(800G)。
OCS:全光網路的交換器
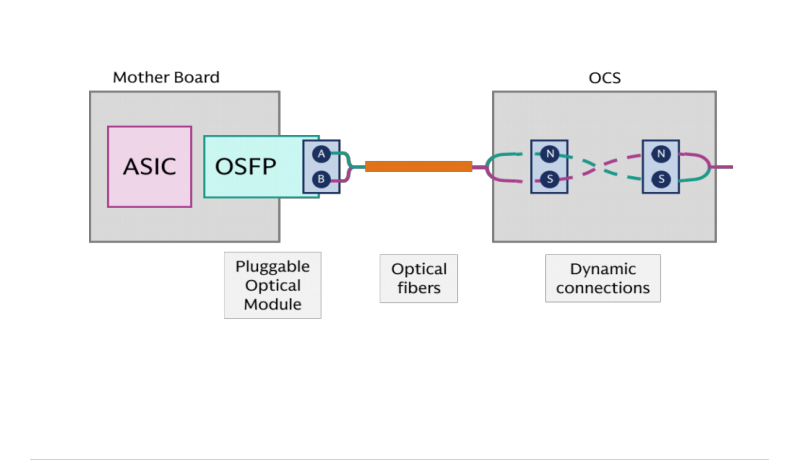
傳統交換器要把光轉成電、交換、再轉回光。光路交換器(OCS,Optical Circuit Switch)從頭到尾都是光。
OCS 在輸入光纖和輸出光纖之間開一條「類比的光路」,光訊號直接通過,不看內容。所以 800G、1.6T、3.2T 的光走的是同一條路,升級速率時不用換交換器,同一台 OCS 還能同時承載不同速率。高盛認為這正是快速變化的 AI 叢集需要的。
- 中際旭創 (中國・300308) 目標 2027 年推出矽光子 OCS。
- 羅博特科 (中國・300757) 宣布拿到歐洲客戶「全自動 OCS 封裝產線」訂單,金額 770 萬歐元。
- Lumentum ($LITE) 的 OCS 積壓訂單在 2026 年 2 月超過 4 億美元。
- Coherent ($COHR) 管理層表示,截至 2026 年 2 月已與超過 10 家客戶接洽 OCS;出貨與積壓訂單包含 64×64 與 320×320 兩種規模,預期 OCS 營收之後逐季成長。
OCS 的十年時間軸
| 年份 | 事件 |
|---|---|
| 2015 | Google 啟動 Apollo OCS 專案,開發 OCS 交換器 |
| 2023 | Google 宣布 TPU v4 是第一台部署 OCS 的超級電腦:4,096 顆晶片由 48 台自研 OCS 互連 |
| 2025 | Google TPU v7 SuperPod 用 OCS 互連 9,216 顆晶片;OCP 宣布新的 OCS 專案,參與者包括 Lumentum、iPronics、Google、NVIDIA、Coherent、Microsoft 等 |
| 2026 | Lumentum 表示正快速擴產以應付客戶需求,積壓訂單已遠超 4 億美元;Coherent 預期 OCS 營收今明兩年放量,已有超過 10 家客戶接洽 |
資料來源:Exhibit 42,Company data、Goldman Sachs Global Investment Research
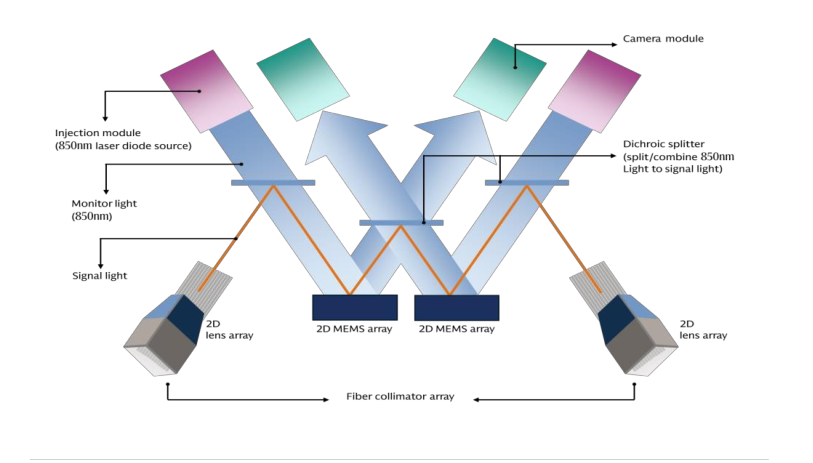
四種 OCS 技術
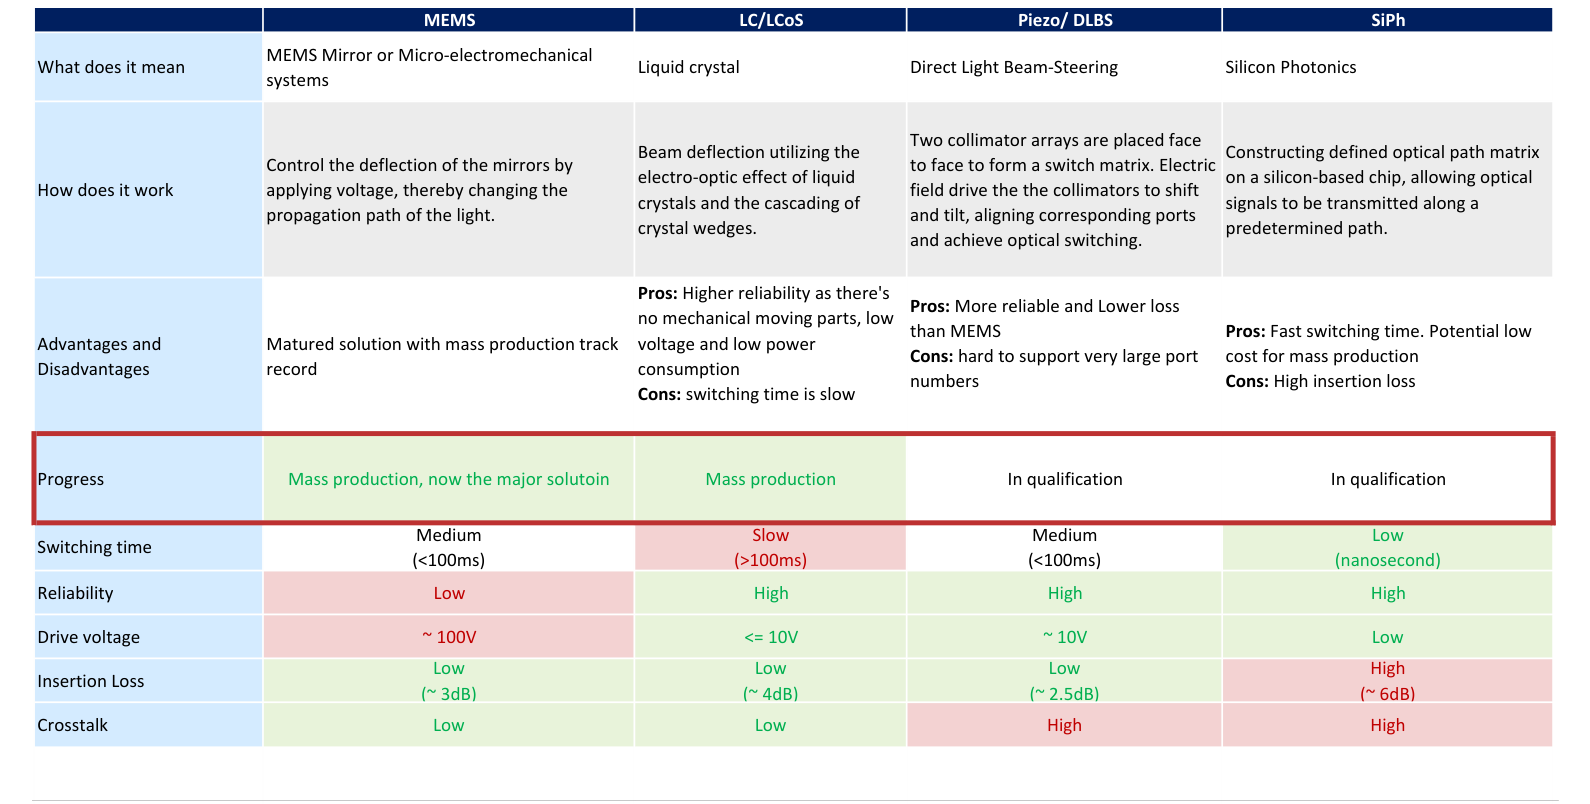
| MEMS | 液晶/LCoS | 壓電/直接光束轉向(DLBS) | 矽光子 | |
|---|---|---|---|---|
| 原理 | 用電壓控制微鏡偏轉,改變光的路徑 | 利用液晶的電光效應偏折光束,多級晶體楔片串接 | 兩組準直器陣列面對面組成交換矩陣,電場推動準直器位移與傾斜,對準對應的埠 | 在矽晶片上建構固定的光路矩陣,光沿預定路徑傳送 |
| 優缺點 | 成熟,有量產紀錄 | 優:沒有機械動件、可靠度高、低電壓低功耗;缺:切換慢 | 優:比 MEMS 可靠、損耗低;缺:難做到很大的埠數 | 優:切換快、量產後可能便宜;缺:插入損耗高 |
| 進度 | 量產,目前主流 | 量產 | 驗證中 | 驗證中 |
| 切換時間 | 中(100 毫秒以內) | 慢(100 毫秒以上) | 中(100 毫秒以內) | 低(奈秒級) |
| 可靠度 | 低 | 高 | 高 | 高 |
| 驅動電壓 | 約 100 V | 10 V 以下 | 約 10 V | 低 |
| 插入損耗 | 低(約 3 dB) | 低(約 4 dB) | 低(約 2.5 dB) | 高(約 6 dB) |
| 串音 | 低 | 低 | 高 | 高 |
資料來源:Exhibit 43,Company data、Goldman Sachs Global Investment Research
查看高盛原表(Exhibit 43)
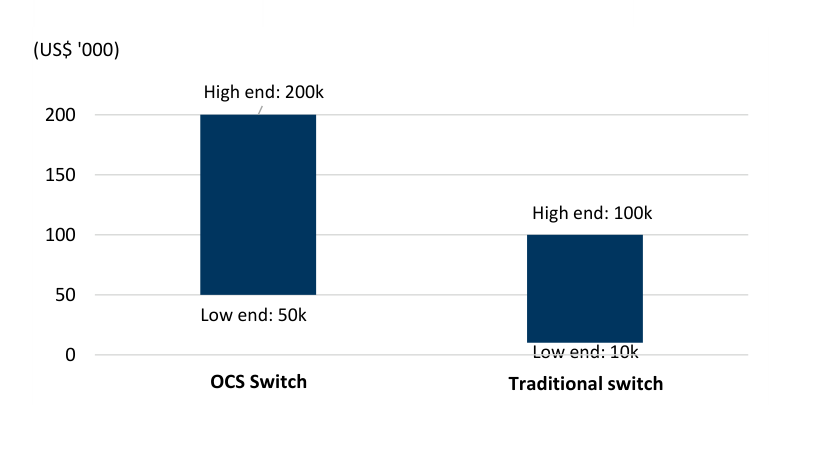
OCS 不便宜。高盛估一台 OCS 交換器 5 萬到 20 萬美元,傳統交換器 1 萬到 10 萬美元。差價買的是「以後升速不用換機」。
七家雲端業者的採用節奏
技術遷移是確定的方向,但每家的腳步不同。
| 技術/廠商 | NVIDIA | Microsoft | Meta | Amazon | Oracle | 中國 CSP | |
|---|---|---|---|---|---|---|---|
| 光模組 800G | |||||||
| 光模組 1.6T | 2027 | 2026 | 2027 | 2027 | 時程未定 | ||
| 光模組 3.2T | 2028 | 2028 | — | — | — | — | — |
| CPO scale-up | — | — | — | — | — | ||
| CPO scale-out | — | — | — | — | |||
| OCS(scale-up 或 scale-out) | — | — | — | — | — | — |
√ 已採用;O 推進中(括號為預期年份)。資料來源:Exhibit 46,Company data、Goldman Sachs Global Investment Research
查看高盛原表(Exhibit 46)
高盛列了四個影響採用速度的因素:
- 舊設施的折舊與使用率。現有產能還沒折舊完,急著換下一代的財務壓力很大。
- 新基礎設施是否就緒。新大樓、電網、散熱設施的施工時間常常拖慢技術遷移。
- 單位成本要先降下來。新技術剛上線時,單位成本遠高於量產之後,很多客戶選擇等。
- 技術方向不確定。技術還在演進、路線有好幾條時,太早重押是風險。
附錄:線材圖解
報告最後兩張圖,把幾種線材畫在一起,適合當備忘。
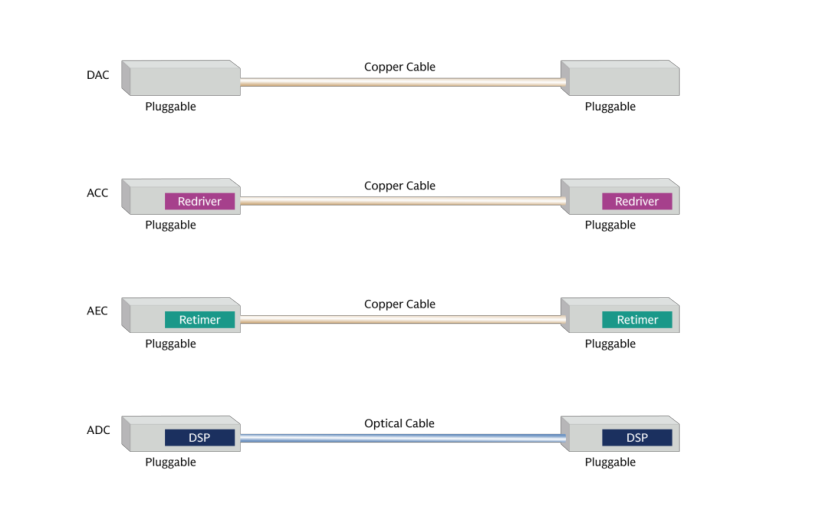
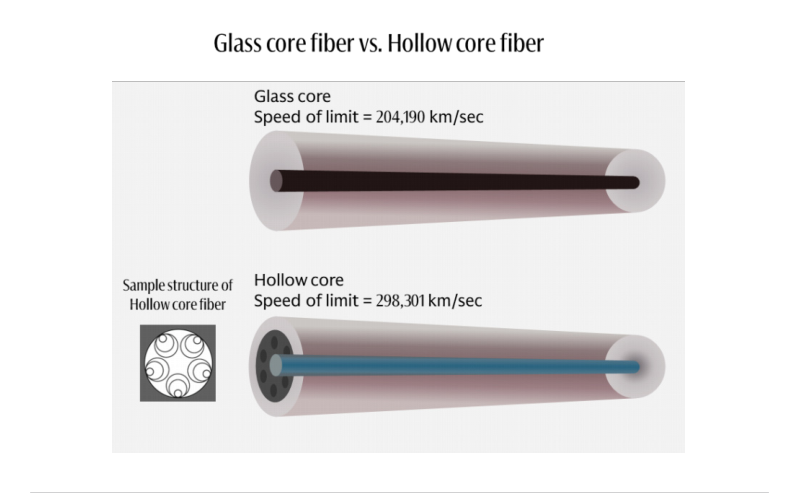
空心光纖的原理很直覺:光在玻璃裡比在空氣裡慢三成。把光纖的芯做成中空,光就在空氣裡走,同樣距離延遲少三成。這對跨城市的 scale-across 特別有價值,因為那裡的延遲主要來自距離本身。
錢落在哪一層:報告點名的公司
只列高盛報告正文與圖表點名的公司;未點名的環節不補,點名也不等於推薦。
| 環節 | 報告點名 |
|---|---|
| 磷化銦基板與雷射(InP、EML、連續波) | 全新 (2455)、聯亞 (3081)、源杰科技 (中國・688498)、Lumentum ($LITE)、Coherent ($COHR) |
| CPO 交換器與光引擎 | NVIDIA ($NVDA)、Broadcom ($AVGO)、Marvell ($MRVL,含 Celestial AI)、Ranovus(加拿大・未上市)× 聯發科 (2454) |
| NPO 交換器 | 銳捷網絡 (中國・301165) |
| 光路交換器(OCS) | Google ($GOOGL,自研 Palomar)、Lumentum ($LITE)、Coherent ($COHR)、中際旭創 (中國・300308)、羅博特科 (中國・300757,封裝產線)、光迅科技 (中國・002281)、iPronics(西班牙・未上市);OCP 的 OCS 專案參與者另有 NVIDIA ($NVDA)、Microsoft ($MSFT) |
| 可插拔光模組 | 未點名個別供應商;高盛預期毛利率走向 48% 到 55% |
| 銅纜與 AEC、PCB 中板、光纖與 MPO、配線盒 | 公開節錄版未點名 |
揭露附錄列出的評等個股只有 Prysmian(義大利・PRY,Buy),對應線纜環節。資料來源:報告全文與 Exhibit 20、42、45,Goldman Sachs Global Investment Research
三部曲回顧
- 1一座 AI 機櫃的網路值多少錢
- 2技術怎麼選:PCB、銅纜、光,與 CPO 登場
- 3誰在用、缺什麼:光源短缺、配比、OCS 與各家採用節奏(本篇)
名詞小抄
這篇的關鍵詞,一句話版。
- 磷化銦 InP, Indium Phosphide
- 做雷射與光偵測器的化合物半導體基板。
- MOCVD Metal-Organic Chemical Vapor Deposition
- 有機金屬化學氣相沉積。長化合物半導體磊晶層的設備,擴產看它的台數。
- LD/PD Laser Diode/Photo Detector
- 雷射二極體與光偵測器。發射端與接收端的核心元件。
- VCSEL Vertical-Cavity Surface-Emitting Laser
- 垂直共振腔面射型雷射。從晶片表面垂直出光的雷射,便宜省電,距離短。
- MicroLED
- 微發光二極體。微米級的 LED 當光源,scale-up 的候選。
- 配比 attach rate
- 每顆 GPU 對應幾顆光模組。
- DSF Disaggregated Scheduled Fabric
- 分散式排程網路架構。Meta 的資料中心網路設計。
- OCS Optical Circuit Switch
- 光路交換器。不做光電轉換、直接切換光路的交換器。
- MEMS Micro-Electro-Mechanical Systems
- 微機電系統。晶片級的微小機械結構,這裡指微鏡陣列。
- LCoS Liquid Crystal on Silicon
- 矽基液晶。用液晶偏折光的技術。
- DLBS Direct Light Beam-Steering
- 直接光束轉向。用壓電元件移動準直器來對準埠。
- 準直器 collimator
- 把光束整理成平行光的元件。
- 插入損耗 insertion loss
- 光經過元件後損失的功率,單位 dB。
- 串音 crosstalk
- 訊號漏到隔壁通道。
- OCP Open Compute Project
- 開放運算計畫。雲端業者共同制定硬體規格的組織。
- OSFP Octal Small Form-factor Pluggable
- 800G/1.6T 光模組常用的封裝規格。
- DAC/ACC/AEC
- 直連銅纜(DAC):無源銅纜,0.5 到 3 公尺;主動銅纜(ACC):加重驅動器,7 到 15 公尺;主動電纜(AEC):加重定時器,5 到 30 公尺。同 Part 2 定義。
- ADC
- Micron 圖中對兩端帶 DSP 的光纜的分類名,報告未註明全名。
- 空心光纖 hollow core fiber
- 芯是空氣而非玻璃的光纖,延遲低三成。
- CSP Cloud Service Provider
- 雲端服務業者。Google、Microsoft、Amazon、Meta、Oracle 等。
- ASIC Application-Specific Integrated Circuit
- 特殊應用晶片。雲端業者自研的 AI 晶片,如 TPU、Trainium、MTIA。
三部曲:一座 AI 機櫃的網路值多少錢 · 技術怎麼選:PCB、銅纜、光,與 CPO 登場 · 誰在用、缺什麼(本篇)